4 Cifras de Fluxo — RC4, Salsa20, ChaCha20 e Padding
Introdução
Os capítulos anteriores trataram sempre de cifras de bloco: DES e AES processam a mensagem em fragmentos de tamanho fixo, 64 ou 128 bits de cada vez, e precisaram de um modo de operação para lidar com mensagens de qualquer comprimento. Este capítulo apresenta a outra grande família de cifras simétricas, as cifras de fluxo, que dispensam essa mecânica: geram uma sequência pseudo-aleatória de bits, byte a byte, tão longa quanto a mensagem, e combinam-na com o texto claro por XOR, sem qualquer noção de bloco. As cifras de fluxo têm ganho renovada relevância nos últimos anos, precisamente por serem rápidas a processar fluxos contínuos de dados e por funcionarem bem em dispositivos com poucos recursos, como sensores sem fios ou etiquetas RFID em sistemas Internet of Things (Martin 2017). Há ainda uma segunda razão, menos técnica: o descrédito generalizado das cifras de bloco em modo CBC, precisamente por causa dos ataques de oráculo de padding já referidos no capítulo anterior, empurrou muitos sistemas modernos na direcção das cifras de fluxo (e das construções AEAD baseadas nelas) (Aumasson 2017).
4.1 Cifras de Fluxo: o Conceito Geral
O modo CTR, apresentado no capítulo anterior, já antecipava esta ideia: usar uma cifra de bloco para gerar uma sequência de valores pseudo-aleatórios, e combiná-la com o texto claro por XOR, tal como uma cifra de fluxo genuína. Uma cifra de fluxo pode ser vista como um caso particular de gerador determinístico de bits aleatórios (deterministic random bit generator, DRBG): a diferença é que um DRBG genérico só recebe um valor de entrada (uma semente), enquanto uma cifra de fluxo recebe sempre dois, a chave \(K\) (secreta, tipicamente de 128 ou 256 bits) e o nonce \(N\) (não precisa de ser secreto, mas tem de ser único para cada chave, tipicamente entre 64 e 128 bits) (Aumasson 2017). A partir destes dois valores, um gerador de fluxo de chave (keystream generator) produz uma sequência de bits \(k_1, k_2, k_3, \dots\), o fluxo de chave (keystream), tão longa quanto necessário, e a cifragem é uma simples combinação por XOR, bit a bit ou byte a byte:
\[C_i = P_i \oplus k_i\]
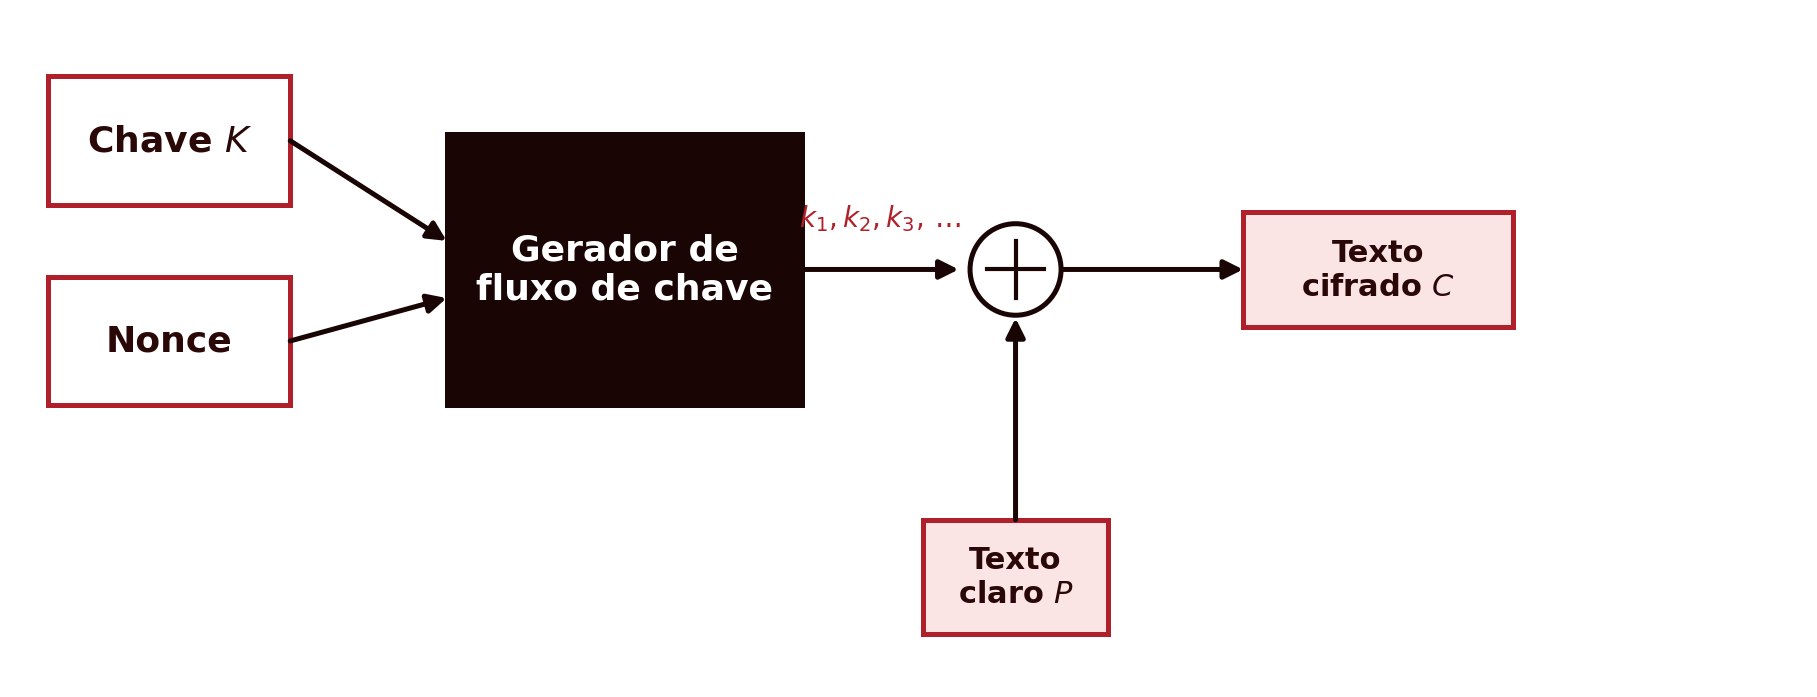
Esta construção devia parecer familiar: é exactamente a estrutura do One-Time Pad, já referido no capítulo 1 e retomado no capítulo 2 como o único sistema com segredo perfeito demonstrado por Shannon. Uma cifra de fluxo pode, por isso, ser vista como o equivalente pseudo-aleatório de um One-Time Pad (Martin 2017; Aumasson 2017): a diferença, e é uma diferença crucial, é que o One-Time Pad exige uma chave genuinamente aleatória, tão longa quanto a mensagem, e nunca reutilizada, enquanto uma cifra de fluxo troca essa exigência impraticável por uma chave curta e reutilizável, à custa de perder o segredo perfeito: a segurança passa a depender inteiramente da imprevisibilidade computacional do gerador, isto é, de ser inviável distinguir o seu fluxo de saída de uma sequência genuinamente aleatória sem conhecer a chave.
Esta troca tem uma consequência que não perdoa erros: o par (chave, nonce) nunca pode ser reutilizado. Note-se que isto é mais permissivo do que possa parecer à primeira vista: cifrar uma mensagem com \((K_1, N_1)\) e outra com o mesmo \(K_1\) mas um \(N_1\) diferente é seguro, tal como cifrar com um \(K_2\) diferente e o mesmo \(N_1\); o que nunca pode acontecer é voltar a cifrar com exactamente o mesmo par \((K_1, N_1)\) já usado antes (Aumasson 2017). Se isso acontecer, o gerador produz exactamente o mesmo fluxo de chave para duas mensagens diferentes. Um atacante que intercepte ambos os textos cifrados pode combiná-los por XOR entre si, e o fluxo de chave cancela-se completamente:
\[C_1 \oplus C_2 = (P_1 \oplus k) \oplus (P_2 \oplus k) = P_1 \oplus P_2\]
O resultado, o XOR dos dois textos claros, já não depende da chave, e é frequentemente suficiente para recuperar ambas as mensagens através de análise estatística da língua, tal como se fez com o método de Kasiski no capítulo 1. Este é o chamado ataque do two-time pad, e foi exactamente o tipo de falha, na reutilização de valores de inicialização, que tornou o protocolo WEP (a primeira norma de segurança Wi-Fi) praticamente inútil.
4.2 RC4
O RC4, desenhado por Ron Rivest na RSA Security em 1987, foi mantido como segredo comercial até ser divulgado, sem autorização, em 1994. Aceita chaves de comprimento variável, entre 40 e 2048 bits, e mantém um estado interno de 256 bytes (um array \(S\), com dois ponteiros auxiliares \(i\) e \(j\)). É orientado a byte (não a bit), e organiza-se em duas fases:
- KSA (Key Scheduling Algorithm): a partir da chave, constrói e permuta o array \(S\) de 256 valores (inicialmente \(S[i]=i\)), misturando-o repetidamente com os bytes da chave.
- PRGA (Pseudo-Random Generation Algorithm): a cada iteração, actualiza os dois ponteiros \(i\) e \(j\), troca \(S[i]\) com \(S[j]\), e produz um byte do fluxo de chave.
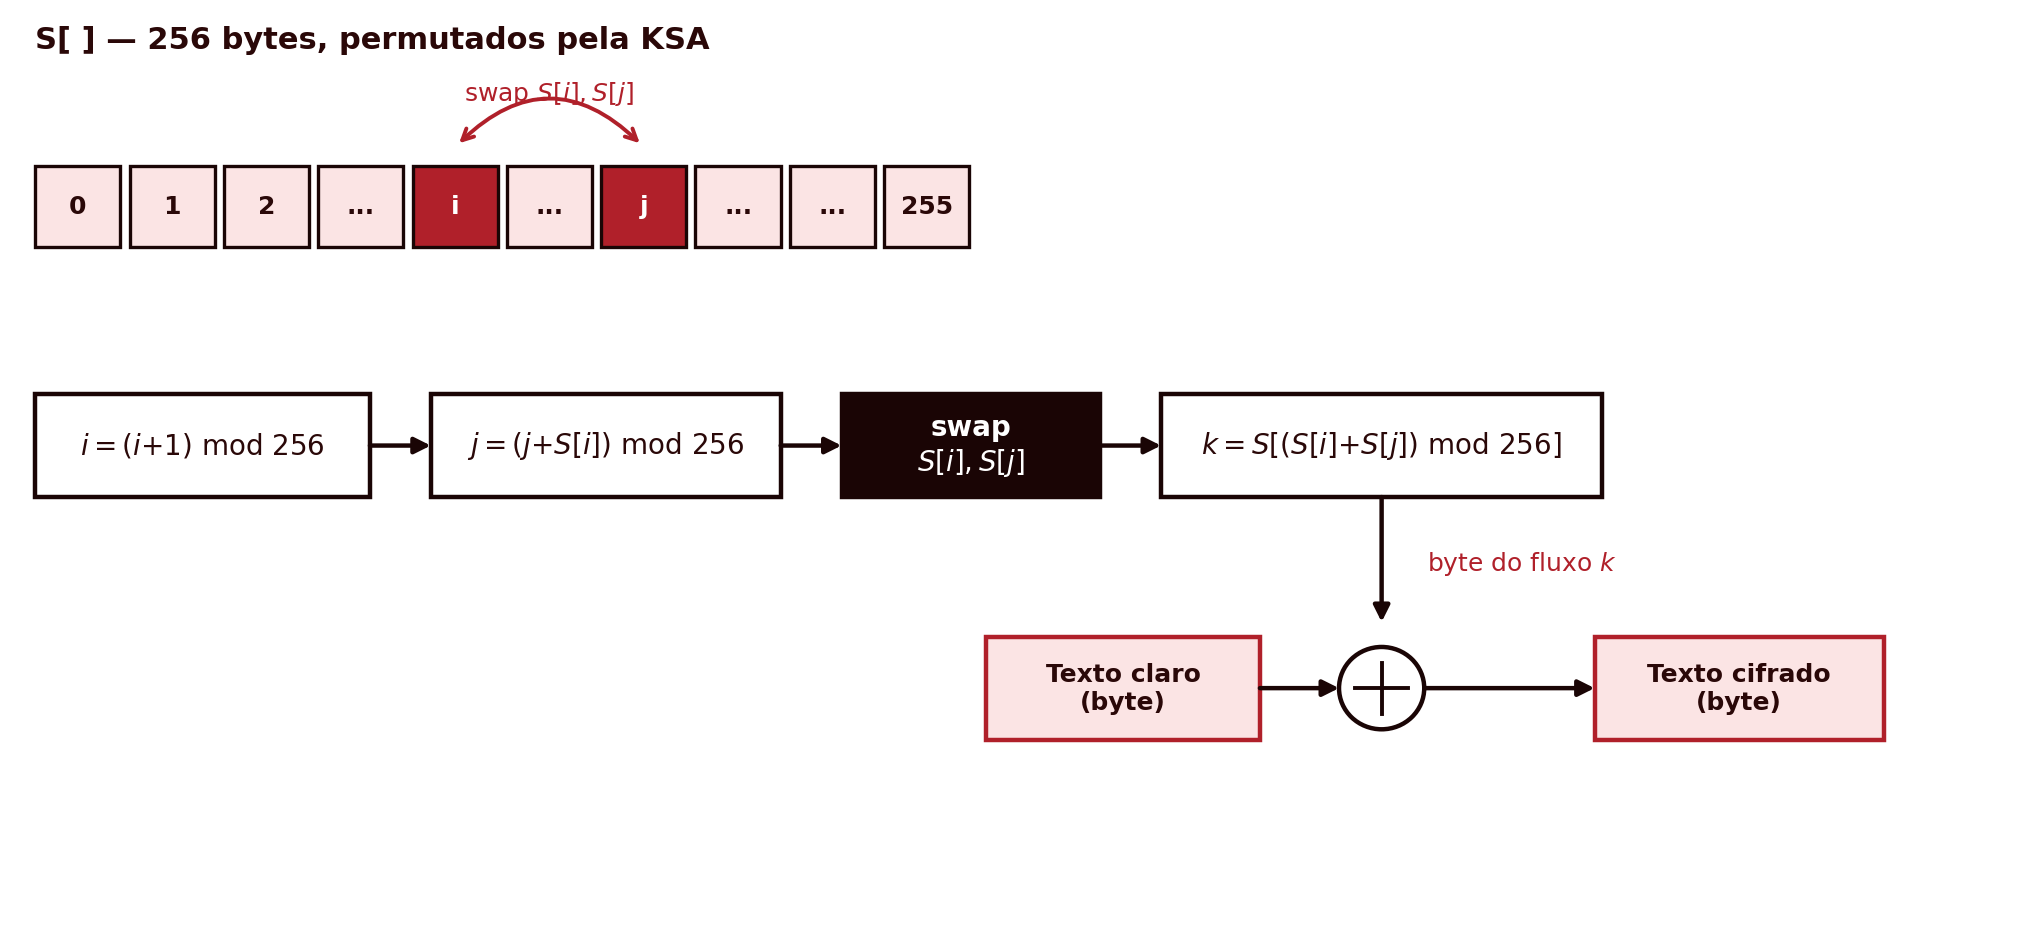
Um detalhe do desenho do RC4 vale a pena assinalar: não existe nenhum mecanismo de nonce incorporado no algoritmo, ao contrário de qualquer cifra de fluxo decente, nas palavras do criptógrafo Jean-Philippe Aumasson (Aumasson 2017). Qualquer nonce tem de ser adicionado externamente, por quem implementa o protocolo, e foi precisamente aqui que o WEP falhou. O WEP usava um nonce (chamado IV) de apenas 24 bits, enviado em claro no cabeçalho de cada pacote, e colava-o à frente da chave secreta partilhada para formar a chave do RC4 (Aumasson 2017). Daqui resultam dois problemas. O primeiro é o tamanho: com IV escolhidos ao acaso, a primeira repetição surge ao fim de cerca de \(2^{12}\) pacotes, uns poucos megabytes de tráfego, e, mesmo que o IV funcione como contador, esgota-se ao fim de poucos gigabytes; um IV repetido dá o mesmo fluxo de chave, isto é, um two-time pad. O segundo é mais grave: como todas as chaves do RC4 partilham a mesma parte secreta e diferem apenas nos três bytes públicos do IV, o atacante conhece o estado da KSA ao fim das três primeiras iterações. É isto que explora o ataque de Fluhrer, Mantin e Shamir (2001) (Fluhrer, Mantin, e Shamir 2001): para certos IV, ditos fracos, o primeiro byte do fluxo de chave depende fortemente do primeiro byte da chave secreta. Como o início do texto claro de quase todos os pacotes é conhecido (um cabeçalho fixo), o atacante obtém o primeiro byte do fluxo de chave por XOR com o texto cifrado e, acumulando pacotes suficientes, recupera a própria chave, byte a byte. Hoje, ferramentas como o aircrack-ng automatizam o ataque completo, da captura do tráfego à criptanálise (Aumasson 2017).
O RC4 tem ainda uma segunda fragilidade, independente do WEP e do nonce: o seu fluxo de chave não é estatisticamente uniforme. O caso mais conhecido, descrito por Mantin e Shamir também em 2001 (Mantin e Shamir 2002), é o do segundo byte do fluxo de chave, que vale zero com uma probabilidade de \(1/128\), o dobro do que seria de esperar (\(1/256\)) num byte verdadeiramente aleatório (Aumasson 2017). Este desvio não revela a chave, mas permite distinguir estatisticamente o RC4 de uma fonte aleatória e, se a mesma mensagem for cifrada com muitas chaves diferentes, recuperar bytes do texto claro sem nunca descobrir a chave. A mitigação proposta, descartar os primeiros 3072 bytes do fluxo antes de o usar (RC4-drop3072), reduz mas não elimina o problema. Um segundo ataque prático, contra o próprio TLS, foi publicado em 2013 (AlFardan et al. 2013). Confrontado com estas fragilidades acumuladas, o RC4 foi formalmente banido do TLS pela Internet Engineering Task Force em 2015 (Popov 2015), e não deve ser usado em nenhum sistema novo.
4.3 Duas Arquitecturas: Stateful vs. por Contador
Antes de avançar para o Salsa20 e o ChaCha20, vale a pena situar o RC4 numa classificação mais geral. As cifras de fluxo organizam-se em duas grandes arquitecturas, consoante a forma como produzem o fluxo de chave (Aumasson 2017).
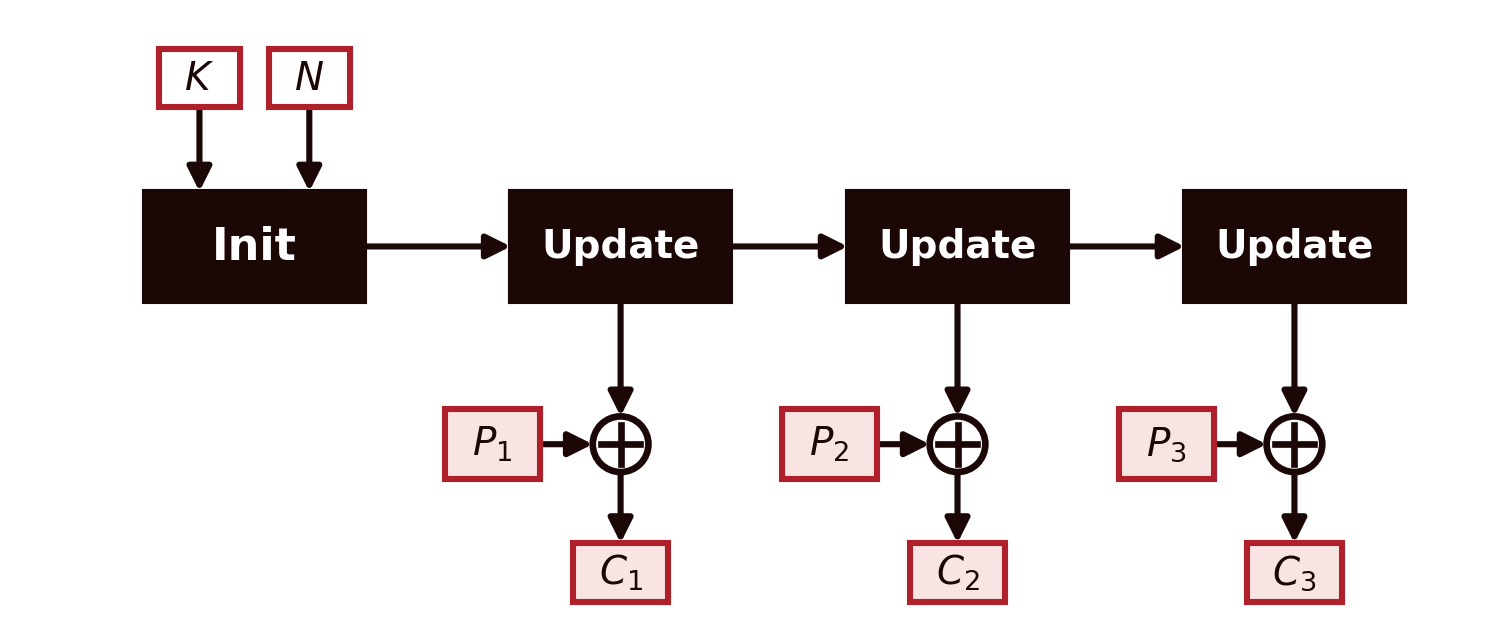
Uma cifra de fluxo com estado (stateful) inicializa um estado interno a partir da chave e do nonce (a fase Init); a partir daí, a chave e o nonce não voltam a ser usados directamente, e toda a informação secreta passa a estar contida no estado. Segue-se a fase Update, repetida tantas vezes quantas as necessárias: cada Update recebe o estado actual e produz duas coisas, o estado seguinte, que passa ao Update seguinte, e um troço do fluxo de chave, que se combina por XOR com o texto claro. O processo é, por isso, sequencial: cada actualização depende da anterior.
A figura mostra apenas esta estrutura, comum a todas as cifras com estado; o algoritmo concreto do Update (tal como o do Init) é próprio de cada cifra. No RC4, já apresentado, o estado é o array \(S\) com os índices \(i\) e \(j\): o Init é a KSA, e cada Update é uma iteração da PRGA, que actualiza \(i\) e \(j\), troca \(S[i]\) com \(S[j]\) (o estado seguinte) e devolve o byte \(S[(S[i]+S[j]) \bmod 256]\) (o troço do fluxo de chave).
Uma cifra de fluxo por contador (counter-based) segue uma lógica diferente: não mantém nenhum estado secreto entre blocos, para além do valor de um contador público. Cada bloco do fluxo de chave calcula-se de novo, directamente a partir da chave, do nonce e do valor do contador nesse bloco — sem depender do resultado do bloco anterior.
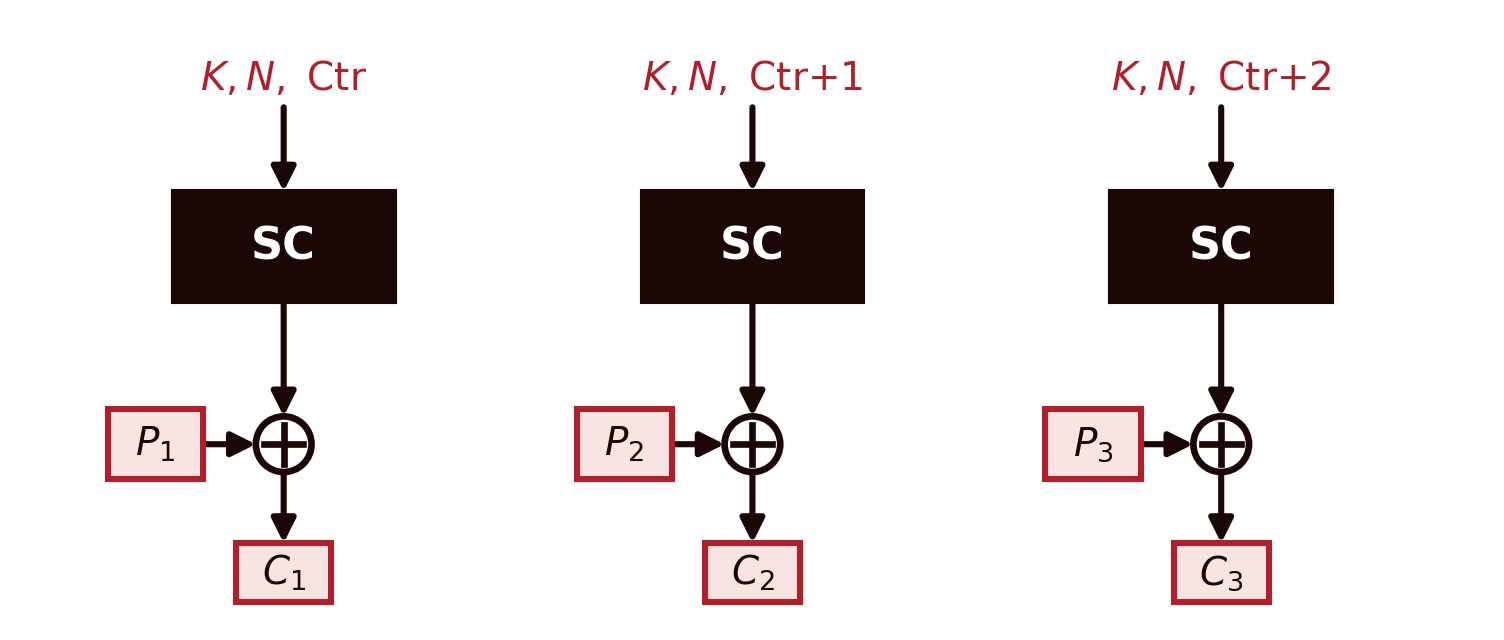
Esta diferença arquitectural tem uma consequência prática directa, já referida a propósito do modo CTR no capítulo anterior: como cada bloco de uma cifra por contador é independente dos restantes, pode calcular-se em paralelo, ao contrário de uma cifra com estado, em que cada actualização tem de esperar pela anterior. O Salsa20 e o ChaCha20, apresentados de seguida, seguem exactamente esta segunda arquitectura.
4.4 Salsa20
Em resposta às fragilidades do RC4, Daniel J. Bernstein desenhou o Salsa20 em 2005, submetido ao concurso eSTREAM (o projecto europeu ECRYPT para cifras de fluxo), onde foi seleccionado para o portefólio final de algoritmos recomendados para software.
Ao contrário do RC4, o Salsa20 não mantém um estado que evolui byte a byte, nem usa S-boxes ou tabelas de substituição. Baseia-se exclusivamente em três operações, soma, rotação de bits e XOR — por isso chamada uma construção ARX (Add-Rotate-XOR). O seu estado interno é uma matriz \(4\times4\) de palavras de 32 bits (512 bits, 64 bytes no total), organizada em quatro grupos: quatro constantes fixas (\(c_0\)–\(c_3\)), a chave de 128 ou 256 bits, dividida em oito palavras (\(k_0\)–\(k_7\)), o nonce de 64 bits, em duas palavras (\(v_0\), \(v_1\)), e um contador de 64 bits, também em duas palavras (\(t_0\), \(t_1\)):
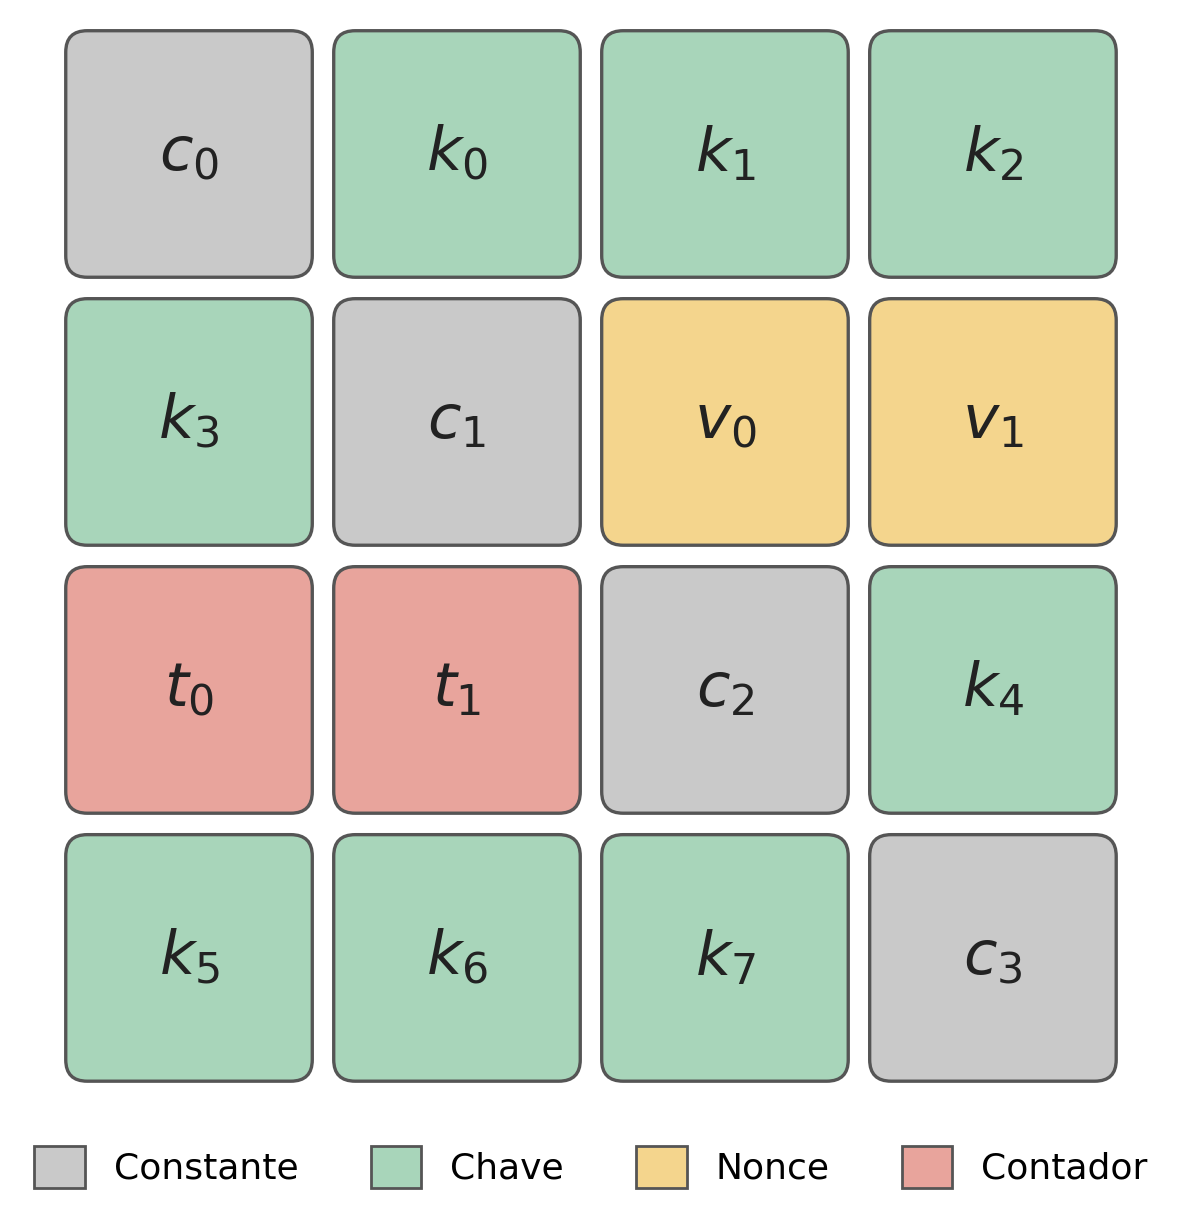
As quatro constantes (\(c_0,c_1,c_2,c_3\)) não fazem parte da chave nem do nonce: são o texto ASCII expand 32-byte k (ou expand 16-byte k, com chave de 128 bits). Este texto tem exactamente 16 caracteres, isto é, 16 bytes ou 128 bits, e ocupa por isso à justa as quatro palavras de 32 bits da diagonal, quatro caracteres em cada: expa (\(c_0\) = 0x61707865), nd 3 (\(c_1\) = 0x3320646e), 2-by (\(c_2\) = 0x79622d32) e te k (\(c_3\) = 0x6b206574).
As constantes são públicas e iguais em todas as execuções, pelo que, no caso normal, nada acrescentam: a chave, o nonce e o contador já tornam o estado variado. Servem para os casos maus. O nonce e o contador são públicos e podem ser influenciados por um atacante, e a chave pode ser fraca; sem constantes, poderia chegar-se a um estado de partida todo a zero, e, como a soma, a rotação e o XOR de zeros dão sempre zero, o fluxo de chave sairia todo a zero. Com quatro das dezasseis palavras sempre fixas, isso torna-se impossível, seja qual for o resto: o atacante só controla parte do estado de partida (Bernstein 2005a).
Para gerar cada bloco de 64 bytes de fluxo de chave, o Salsa20 aplica ao estado 20 rondas de uma função de quarto de ronda, \(Q_R(a,b,c,d)\), que transforma quatro palavras de 32 bits:
\[b \mathrel{\oplus}= (a+d) \lll 7 \qquad c \mathrel{\oplus}= (b+a) \lll 9\] \[d \mathrel{\oplus}= (c+b) \lll 13 \qquad a \mathrel{\oplus}= (d+c) \lll 18\]
Cada linha faz o mesmo tipo de operação: soma duas palavras (módulo \(2^{32}\)), roda o resultado um certo número de bits para a esquerda (7, 9, 13 e 18) e combina-o por XOR com uma terceira palavra. As linhas calculam-se de cima para baixo, pelo que cada nova palavra depende das que acabaram de ser alteradas. Uma ronda de colunas aplica \(Q_R\) às quatro colunas da matriz, de forma independente, e uma ronda de linhas aplica-a às quatro linhas; as duas juntas formam uma ronda dupla, e o Salsa20 repete 10 rondas duplas, num total de 20 rondas (Aumasson 2017).
O efeito destas operações simples é uma difusão muito rápida: se dois estados iniciais diferirem num único bit, ao fim de apenas quatro rondas já difere cerca de metade dos 512 bits do estado, tanto quanto entre dois estados escolhidos ao acaso. A mistura de soma e XOR é também o que torna as rondas não lineares: só com XOR, as diferenças propagar-se-iam na mesma, mas o processo seria linear e, por isso, inseguro (Aumasson 2017).
Terminadas as 20 rondas, o resultado soma-se (módulo \(2^{32}\), palavra a palavra) ao estado inicial, e só então se obtém o bloco de fluxo de chave.
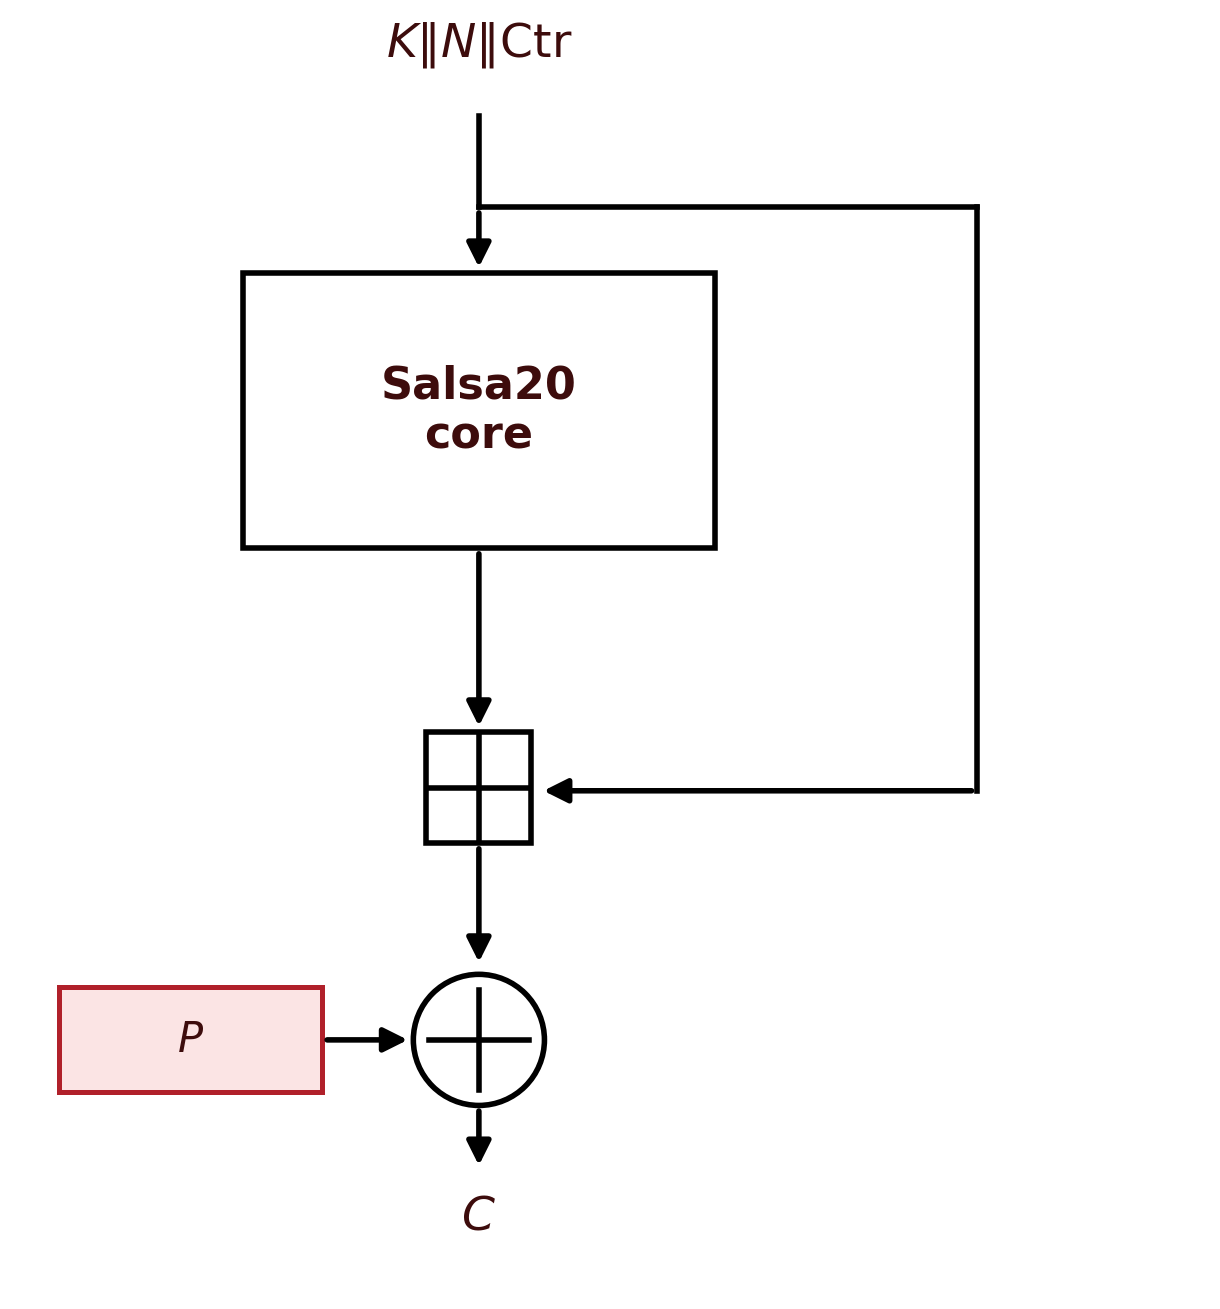
Esta soma final é indispensável, e a razão não tem que ver com a não-linearidade. As 20 rondas, por si sós, não usam nenhuma chave: são uma permutação pública, e cada um dos seus passos pode ser desfeito, porque consiste em fazer XOR de uma palavra com um valor calculado a partir de outras que esse passo não altera, e repetir o mesmo XOR anula-o. Se o Salsa20 devolvesse directamente o resultado das rondas, qualquer pessoa poderia desfazê-las, passo a passo, e recuperar o estado inicial, incluindo a chave. Ao somar o estado inicial ao resultado, a saída passa a misturar a permutação com a própria chave, e desfazer essa soma exigiria conhecer precisamente o que se quer descobrir (Aumasson 2017). Repare-se, por isso, na distinção entre as duas operações da figura: a soma final ao estado inicial (quadrado) é adição modular, e só depois dela o resultado se combina por XOR (círculo) com o texto claro.
Como cada bloco de 64 bytes é gerado de forma independente dos restantes (a partir da chave, do nonce e do valor do contador nesse bloco), o Salsa20 é inteiramente paralelizável, tanto na cifragem como na decifragem.
O melhor ataque conhecido contra o Salsa20 atinge apenas a versão reduzida de 8 rondas, o Salsa20/8, e é sobretudo teórico: exige cerca de \(2^{251}\) operações, contra as \(2^{256}\) de uma pesquisa exaustiva da chave (Aumasson 2017). A versão completa, de 20 rondas, tem por isso uma margem de segurança larga e não tem, até hoje, nenhum ataque prático conhecido.
4.5 ChaCha20
O ChaCha20, também desenhado por Bernstein, em 2008, é uma variante do Salsa20 com uma função de quarto de ronda modificada, que alcança melhor difusão por ronda: em cada quarto de ronda, o ChaCha20 altera cada uma das quatro palavras duas vezes, enquanto o Salsa20 altera cada uma só uma vez, e por isso o efeito de cada bit espalha-se mais depressa pelo resto do estado. É hoje a cifra de fluxo de referência, usada, entre outros, no TLS 1.3, no QUIC, no WireGuard, no SSH e por omissão no OpenSSH desde 2014.
\[a \mathrel{+}= b;\ d \mathrel{\oplus}= a;\ d \lll 16 \qquad c \mathrel{+}= d;\ b \mathrel{\oplus}= c;\ b \lll 12\] \[a \mathrel{+}= b;\ d \mathrel{\oplus}= a;\ d \lll 8 \qquad c \mathrel{+}= d;\ b \mathrel{\oplus}= c;\ b \lll 7\]
As constantes de rotação (16, 12, 8, 7) e a ordem das operações são diferentes das do Salsa20 (7, 9, 13, 18), precisamente para conseguir essa difusão mais rápida.
Há uma segunda diferença, na divisão do estado. O ChaCha20 original de Bernstein mantinha a divisão do Salsa20, com um nonce de 64 bits e um contador de 64 bits; a versão normalizada pelo IETF no RFC 8439 passou a usar um nonce de 96 bits e um contador de 32 bits (Nir e Langley 2018). Como o bloco de estado continua a ter 512 bits, os 32 bits que o nonce ganha são retirados ao contador.
A razão é a margem contra a repetição do nonce. Se os nonces forem escolhidos ao acaso, com \(n\) bits, é de esperar a primeira repetição ao fim de cerca de \(2^{n/2}\) mensagens, e não de \(2^n\) (Aumasson 2017): o número de pares possíveis entre as mensagens já enviadas cresce com o quadrado do número de mensagens, e basta que um desses pares coincida. É o mesmo fenómeno do chamado paradoxo do aniversário: num grupo de apenas 23 pessoas, é mais provável do que não que duas façam anos no mesmo dia, apesar de haver 365 dias possíveis. Com 64 bits, a repetição passa a ser provável ao fim de cerca de \(2^{32}\) mensagens, pouco mais de quatro mil milhões, um número que Aumasson considera inaceitavelmente baixo (Aumasson 2017); e cada repetição é um two-time pad. Com 96 bits, esse limiar sobe para cerca de \(2^{48}\) mensagens. O nonce maior permite também repartir o espaço de nonces quando vários emissores partilham a mesma chave: o RFC 8439 sugere reservar os primeiros 32 bits para identificar o emissor e usar os 64 restantes como contador de mensagens, o que garante que dois emissores nunca produzem o mesmo nonce (Nir e Langley 2018).
O preço é o contador mais pequeno: com 32 bits, um único par (chave, nonce) só pode gerar \(2^{32}\) blocos de 64 bytes, isto é, 256 GB de fluxo de chave, um limite que, segundo o próprio RFC, é suficiente para a maioria das utilizações (Nir e Langley 2018).
Toda esta atenção à difusão pode parecer desperdiçada, porque no fim o fluxo de chave combina-se com o texto claro por um simples XOR, que não espalha nada: cada bit do texto cifrado depende de um único bit do texto claro. A contradição é só aparente, porque numa cifra de fluxo a difusão serve outro objectivo. A confidencialidade não precisa de difusão sobre o texto claro: o modelo é o One-Time Pad, em que o XOR com uma sequência verdadeiramente aleatória dá segredo perfeito sem espalhar coisa nenhuma. O que é preciso garantir é que o fluxo de chave seja indistinguível de uma sequência aleatória, e é aí que a difusão das rondas actua. Um atacante obtém frequentemente troços do fluxo de chave: basta-lhe conhecer parte do texto claro, como um cabeçalho fixo, e fazer XOR com o texto cifrado correspondente. A difusão garante que esses troços não revelam a chave, porque cada bit do fluxo de chave depende, de forma complexa, de todos os bits da chave, do nonce e do contador; e garante também que não revelam os blocos vizinhos, porque mudar o contador numa unidade altera, em média, metade dos 512 bits do bloco de fluxo de chave. Nas cifras de bloco, pelo contrário, a difusão tem de servir as duas coisas ao mesmo tempo: cada bit do texto cifrado depende de todos os bits do bloco de texto claro e de todos os bits da chave.
A ausência de difusão sobre o texto claro tem, no entanto, um preço. Uma cifra de fluxo, por si só, garante apenas confidencialidade: impede o atacante de ler a mensagem, mas não o impede de a alterar. Como o texto claro se obtém fazendo \(P = C \oplus k\), mudar um bit do texto cifrado muda exactamente o mesmo bit do texto claro decifrado. Um atacante que conheça o formato da mensagem, por exemplo TRANSFERIR 100 EUR, e saiba em que posição está o valor, pode fazer XOR do texto cifrado com 100 \(\oplus\) 900 nessas posições, e o destinatário decifrará TRANSFERIR 900 EUR, sem que o atacante tenha alguma vez conhecido a chave. Para detectar alterações deste tipo, junta-se à mensagem uma marca de autenticação (tag): um valor curto, calculado a partir da mensagem e de uma chave secreta que só o emissor e o destinatário conhecem. O destinatário recalcula a marca sobre a mensagem que recebeu e compara-a com a que veio junto: se a mensagem tiver sido alterada, as duas não coincidem, e o atacante, sem a chave, não consegue calcular a marca certa para a mensagem alterada. Um algoritmo que calcula marcas destas chama-se, em inglês, message authentication code (MAC).
O ChaCha20 é frequentemente combinado com um MAC, o Poly1305, na construção ChaCha20-Poly1305, normalizada no RFC 8439 (Nir e Langley 2018).
O Poly1305 (Bernstein 2005b) não cifra nada: o seu único trabalho é calcular uma marca de autenticação de 128 bits. Essa marca cobre o texto cifrado e também os dados adicionais autenticados (additional authenticated data, AAD): partes da mensagem que têm de seguir em claro, mas que não podem ser alteradas. O exemplo típico é o cabeçalho de um pacote de rede, com o endereço de destino: não pode ser cifrado, porque os equipamentos de rede precisam de o ler para encaminhar o pacote, mas, se um atacante o alterar, a marca deixa de coincidir e o receptor detecta a alteração.
A particularidade mais importante do Poly1305, mesmo sem entrar em detalhe sobre o mecanismo interno, é que a sua chave só pode ser usada uma única vez, para uma única mensagem — é um autenticador de utilização única (one-time authenticator), tal como uma cifra de fluxo nunca pode reutilizar o par (chave, nonce). Reutilizar a mesma chave do Poly1305 em duas mensagens permite a um atacante falsificar marcas futuras sob essa chave. É exactamente esta exigência que a construção ChaCha20-Poly1305 resolve: o primeiro bloco gerado pelo ChaCha20 (bloco 0) deriva uma chave de Poly1305 nova a partir da chave e do nonce dessa mensagem, garantindo automaticamente uma chave descartável por mensagem, mesmo que a chave do ChaCha20 seja reutilizada em muitas mensagens sucessivas. Os blocos seguintes do ChaCha20 (1 a \(m\)) fornecem o fluxo de chave que cifra a mensagem por XOR, e só depois o Poly1305 entra em acção, calculando a marca sobre o resultado.
Por ser apenas multiplicação e redução modular, sem S-boxes nem rondas de cifra, o Poly1305 é extremamente rápido mesmo em software puro, sem hardware dedicado — ao contrário do AES-GCM, que tipicamente depende de instruções como o AES-NI para atingir bom desempenho. Foi esta vantagem que levou a Google a promover o ChaCha20-Poly1305 no TLS antes de o AES-NI se ter tornado universal em dispositivos móveis.
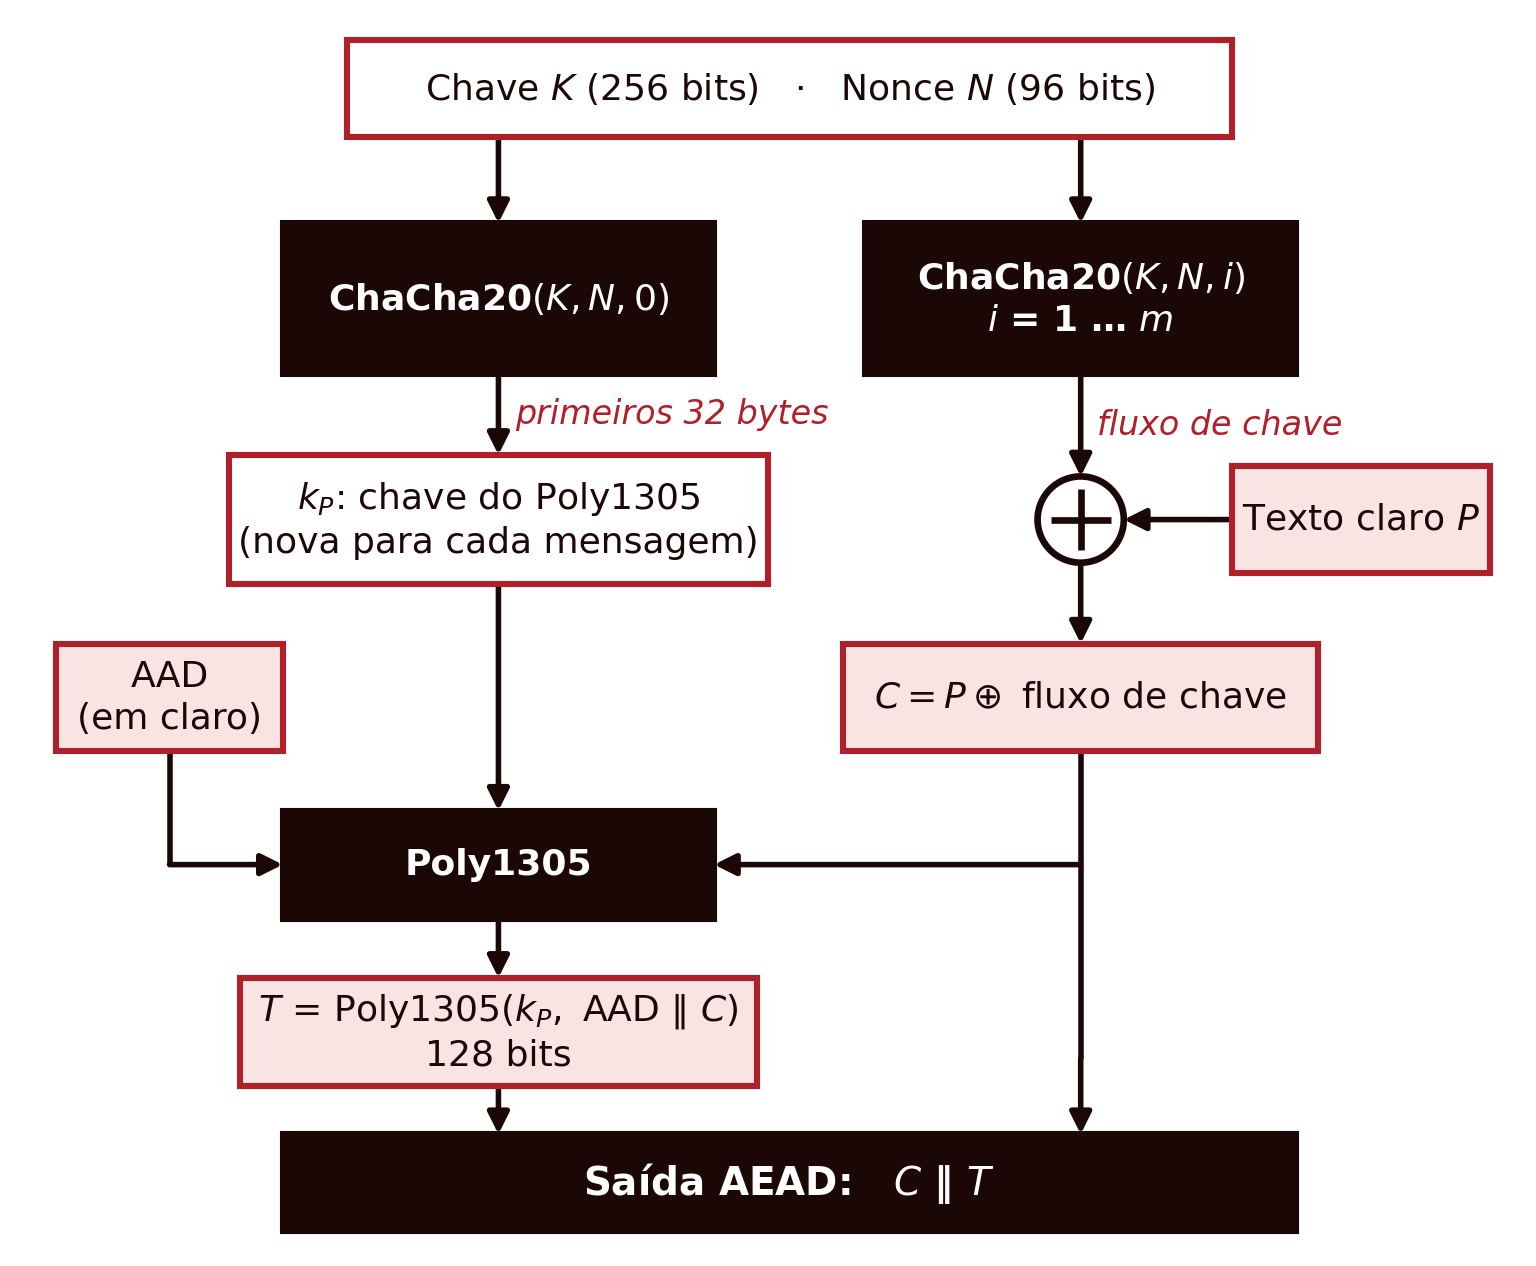
Esta é uma cifra autenticada (AEAD, Authenticated Encryption with Associated Data), o mesmo conceito já introduzido a propósito do modo GCM no capítulo anterior: garante simultaneamente confidencialidade e integridade, numa única construção. O ChaCha20, tal como o Salsa20, não tem, até hoje, nenhuma fragilidade estatística conhecida que o torne distinguível de uma fonte aleatória.
4.6 Síntese do Capítulo
Este capítulo apresentou a segunda grande família de cifras simétricas:
- Uma cifra de fluxo gera um fluxo de chave pseudo-aleatório, combinado com o texto claro por XOR, byte a byte, sem noção de bloco: é o equivalente pseudo-aleatório do One-Time Pad
- Nunca se pode reutilizar o mesmo par (chave, nonce): fazê-lo permite o ataque do two-time pad, que cancela o fluxo de chave e expõe o XOR dos dois textos claros. Com nonces escolhidos ao acaso, de \(n\) bits, a primeira repetição surge ao fim de cerca de \(2^{n/2}\) mensagens, razão pela qual o ChaCha20 normalizado usa um nonce de 96 bits
- O RC4 não tem nonce incorporado. No WEP, o IV de 24 bits colado à chave tornou possível o ataque de Fluhrer, Mantin e Shamir (2001), que recupera a própria chave; o fluxo de chave do RC4 é, além disso, estatisticamente enviesado (Mantin e Shamir, 2001; AlFardan et al., 2013), e o algoritmo está hoje proibido no TLS
- As cifras de fluxo seguem duas arquitecturas: com estado, como o RC4, em que cada actualização depende da anterior, e por contador, como o Salsa20 e o ChaCha20, construções ARX (soma, rotação, XOR) de Bernstein em que cada bloco é independente e o cálculo é paralelizável
- Uma cifra de fluxo garante confidencialidade, mas não integridade: um atacante pode alterar o texto claro alterando o texto cifrado, pelo que é preciso juntar uma marca de autenticação. O ChaCha20-Poly1305 junta as duas coisas numa construção AEAD, e é hoje a referência em protocolos como o TLS 1.3, o QUIC, o WireGuard e o SSH
4.7 Para Pensar
O Salsa20 e o ChaCha20 investem 20 rondas na difusão do fluxo de chave, mas no fim o XOR com o texto claro não espalha nada: cada bit do texto cifrado depende de um único bit do texto claro. Para que serve então essa difusão? E que consequência tem a falta de difusão sobre o texto claro?